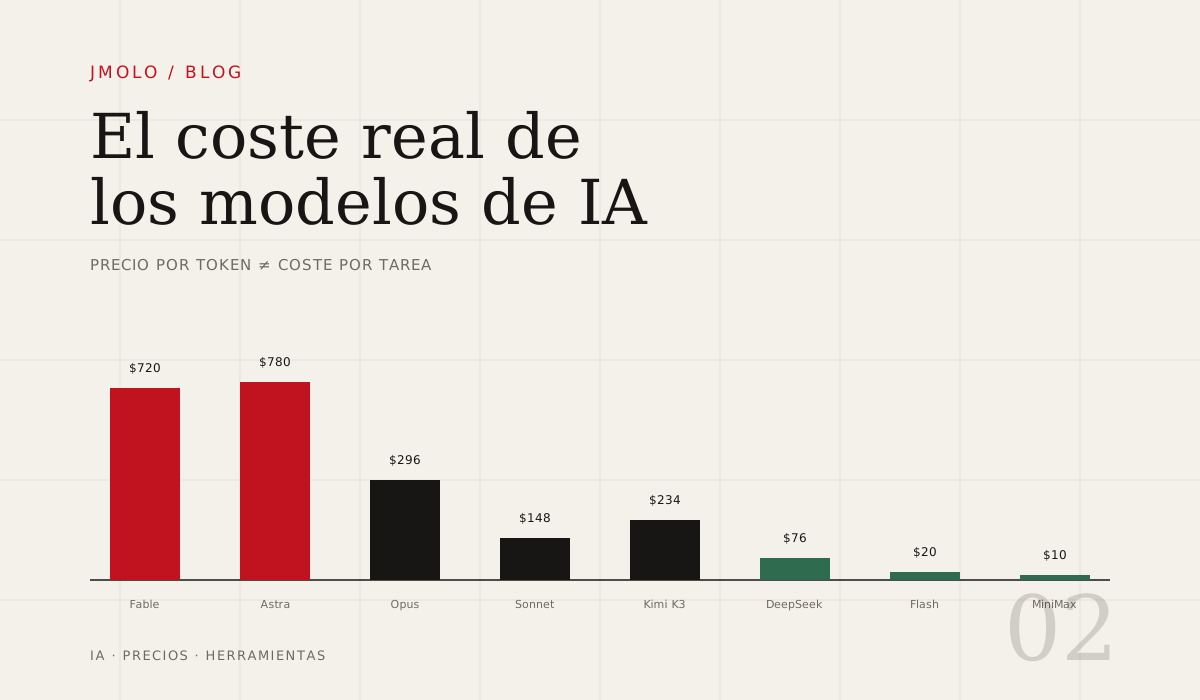
Cada pocas semanas aparece una tabla nueva de precios por millón de tokens. La comparación es útil, pero engañosa: dos modelos con el mismo precio por token pueden costar muy distinto para la misma tarea. La razón es que el coste depende del volumen de entrada, de la proporción que acierta en caché, de la cantidad de salida, de los reintentos, de las herramientas y, sobre todo, del tiempo humano que hace falta para revisar el resultado.
Este artículo pone números concretos. Usa precios oficiales consultados el 20 de octubre de 2026, calcula un escenario mensual para un agente de código y explica qué palancas cambian la factura. No es una recomendación de compra: los precios y los modelos cambian, pero la estructura del cálculo se mantiene.
El escenario
Para comparar de forma justa, hace falta un trabajo reproducible. El escenario es el siguiente:
- 100 millones de tokens de entrada al mes.
- 80 % de esa entrada acierta en caché (80 M cacheados, 20 M sin caché).
- 10 millones de tokens de salida al mes.
- Un agente de código que lee el repositorio, propone cambios, ejecuta pruebas y repite cuando algo falla.
- Precios de lista, sin impuestos, sin descuentos por volumen y sin batch.
No es un usuario extremo. Un equipo pequeño que use un agente varias horas al día puede acercarse a esas cifras, sobre todo si el contexto incluye documentación, archivos de configuración y resultados de pruebas. El escenario permite comparar modelos, no predecir una factura exacta.
Precios de lista
La tabla siguiente recoge modelos representativos de tres grupos: frontera, intermedios y flash. Los importes son dólares por millón de tokens. La columna de caché se refiere a la lectura de caché, no a la escritura.
| Modelo | Proveedor | Entrada | Entrada cacheada | Salida | Notas |
|---|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 10,00 | 0,25 | 50,00 | Frontera; escritura de caché 12,50 |
| Claude Opus 5.5 | Anthropic | 4,00 | 0,20 | 20,00 | Frontera de uso general |
| Claude Sonnet 5.5 | Anthropic | 2,00 | 0,10 | 10,00 | Equilibrio coste/capacidad |
| Claude Haiku 5.5 | Anthropic | 0,10 | 0,01 | 0,50 | Contexto ≤ 100k; por encima cambia |
| GPT-6 Astra | OpenAI | 10,00 | 1,00 | 50,00 | Frontera; contexto largo más caro |
| GPT-6.1 Sol | OpenAI | 2,00 | 0,10 | 10,00 | Uso general |
| GPT-6 Luna | OpenAI | 0,10 | 0,01 | 0,50 | Flash |
| Gemini 4 Argon | 2,00 | 0,10 | 10,00 | Promoción hasta 30/11/2026; luego 4/0,20/20 | |
| Kimi K3 | Moonshot | 3,00 | 0,30 | 15,00 | Contexto muy largo |
| Qwen3.8 Max | Alibaba | 2,00 | 0,25 | 6,00 | Salida comparativamente barata |
| MiniMax M3 | MiniMax | 0,30 | 0,06 | 1,20 | 50 % permanente; contexto ≤ 512k |
| DeepSeek V4.1 Flash | DeepSeek | 0,30 | 0,03 | 1,20 | Pico; fuera de pico, la mitad |
| DeepSeek V4 Pro | DeepSeek | 1,32 | 0,132 | 3,96 | Pico; fuera de pico, la mitad |
Dos avisos antes de sacar conclusiones. El primero: los tokenizadores no son equivalentes. Anthropic indica que su tokenizador para Claude 4.7 y posteriores produce alrededor de un 30 % más de tokens para el mismo texto que el anterior. Un precio por token más bajo puede quedar compensado por un mayor número de tokens. El segundo: los precios de DeepSeek se publican en yuanes; aquí se convierten a dólares con un tipo de cambio aproximado y se redondean. La fuente original manda.
El cálculo, paso a paso
Con el escenario anterior, el coste mensual se calcula así:
coste =
  (20 M / 1M) × precio_entrada
+ (80 M / 1M) × precio_caché
+ (10 M / 1M) × precio_salida
+ reintentos
+ herramientas
+ revisión humana
Aplicado a los modelos de la tabla:
| Modelo | Entrada sin caché | Entrada cacheada | Salida | Total mensual |
|---|---|---|---|---|
| GPT-6 Astra | 200,00 | 80,00 | 500,00 | 780,00 |
| Claude Fable 5.1 | 200,00 | 20,00 | 500,00 | 720,00 |
| Claude Opus 5.5 | 80,00 | 16,00 | 200,00 | 296,00 |
| Kimi K3 | 60,00 | 24,00 | 150,00 | 234,00 |
| Claude Sonnet 5.5 | 40,00 | 8,00 | 100,00 | 148,00 |
| GPT-6.1 Sol | 40,00 | 8,00 | 100,00 | 148,00 |
| Gemini 4 Argon | 40,00 | 8,00 | 100,00 | 148,00 |
| Qwen3.8 Max | 40,00 | 20,00 | 60,00 | 120,00 |
| DeepSeek V4 Pro | 26,40 | 10,56 | 39,60 | 76,56 |
| DeepSeek V4.1 Flash | 6,00 | 2,40 | 12,00 | 20,40 |
| MiniMax M3 | 6,00 | 4,80 | 12,00 | 22,80 |
| Claude Haiku 5.5 | 2,00 | 0,80 | 5,00 | 7,80 |
| GPT-6 Luna | 2,00 | 0,80 | 5,00 | 7,80 |
- GPT-6 Astra780 USD
- Claude Fable 5.1720 USD
- Claude Opus 5.5296 USD
- Kimi K3234 USD
- Claude Sonnet 5.5148 USD
- Qwen3.8 Max120 USD
- DeepSeek V4 Pro76,56 USD
- DeepSeek V4.1 Flash20,4 USD
- MiniMax M322,8 USD
- Claude Haiku 5.57,8 USD
La primera lectura es obvia: la diferencia entre un modelo frontera y un flash es de dos órdenes de magnitud. La segunda es más importante: la salida domina la factura. En este escenario, más de la mitad del coste de GPT-6 Astra y Fable 5.1 viene de los 10 M de tokens de salida. Si el agente escribe más de lo necesario, el ahorro en entrada no compensa.
La caché no es un descuento automático
La caché de contexto reduce el precio de los tokens que se repiten. En el escenario, el 80 % de la entrada está cacheada, lo que rebaja mucho la factura. Pero la caché tiene condiciones:
- La escritura cuesta más que la lectura. En Anthropic, escribir en caché cuesta 12,50 USD por millón en Fable 5.1, frente a 0,25 de lectura. Si el contexto cambia en cada petición, se paga la escritura una y otra vez.
- Hay que acertar. Un prefijo distinto invalida la caché. Cambiar el orden de los archivos, una marca de tiempo o una instrucción al principio puede romper el prefijo.
- La ventana importa. Los proveedores tienen TTL distintos (5 minutos, 1 hora). Un agente que trabaja a ráfagas puede no aprovechar la caché.
- Lo cacheado también se paga. No es gratis; es más barato. El ahorro depende de la proporción de aciertos.
Una forma sana de medir es separar los tokens en tres cubos: entrada nueva, entrada cacheada y salida. Si solo se mira el total de entrada, la caché parece magia; si se mira la escritura, se entiende por qué algunos flujos no ahorran tanto.
El coste que no aparece en la tabla
La factura de la API es solo una parte. Un agente de código consume tiempo de revisión, ejecuta herramientas y, a veces, introduce errores que hay que corregir. Para comparar modelos, hay que incluir ese coste.
Supongamos que una hora de revisión cuesta 60 €. El modelo A cuesta 150 € al mes y requiere 10 horas de revisión. El modelo B cuesta 20 € al mes y requiere 13 horas. La diferencia de API es de 130 € a favor de B; la diferencia de revisión es de 180 € en contra. En total, B cuesta 50 € más. La cuenta no siempre es tan limpia, pero el orden de magnitud importa.
Hay tres costes ocultos que conviene medir:
- Reintentos. Un modelo que falla una herramienta o pierde el formato obliga a repetir la petición. Un 20 % de reintentos puede pesar más que la diferencia de precio por token.
- Contexto inflado. Pasar el repositorio entero en cada turno aumenta la entrada y reduce la precisión. Más tokens no equivalen a mejor respuesta.
- Revisión. Un diff grande, aunque sea correcto, cuesta más de revisar. La calidad del cambio incluye su tamaño.
Qué modelo usar para qué
No hay un ganador único. La elección razonable depende del riesgo y de la forma del trabajo:
- Frontera para decisiones ambiguas. Arquitectura, seguridad, migraciones delicadas, bugs que no se reproducen. El coste por token es alto, pero el coste de una decisión equivocada también.
- Intermedio para el trabajo diario. Implementar una pantalla, conectar una API, escribir pruebas, revisar un módulo. Es donde suele estar el mejor equilibrio.
- Flash para tareas acotadas. Clasificar, extraer datos, resumir, generar boilerplate, convertir formatos, redactar mensajes de error. Si la tarea tiene un criterio claro y una prueba automática, un modelo barato puede bastar.
- Modelos locales para datos que no deben salir. Si el contexto contiene información sensible o el volumen es alto, un modelo local elimina la dependencia de la API, a cambio de hardware, latencia y mantenimiento.
La tentación de usar el modelo más barato para todo es comprensible y suele salir cara. La tentación contraria, usar el más caro para todo, también. La palanca real es enrutar por tarea y medir el resultado con una evaluación propia.
Cómo medir el coste de verdad
Un cálculo mensual sirve para presupuestar, no para optimizar. Para optimizar hace falta medir por tarea:
- Definir una muestra. Diez o veinte tareas representativas del trabajo real, con su resultado esperado.
- Medir tokens y tiempo. Entrada nueva, entrada cacheada, salida, herramienta, reintentos y minutos de revisión.
- Calcular el coste completo. API más tiempo humano. Un modelo barato que exige más revisión puede perder.
- Repetir con otro modelo. El mismo conjunto de tareas, no una impresión general.
- Revisar cada mes. Los precios cambian, los modelos se actualizan y el trabajo evoluciona.
La métrica útil no es “coste por millón de tokens”, sino coste por tarea aceptada. Esa métrica incluye la calidad y el tiempo, que son la parte que realmente se nota.
Conclusión
El precio por token es un dato de partida, no una respuesta. En el escenario de 100 M de entrada y 10 M de salida, la diferencia entre los modelos de la tabla va de 7,80 a 780 USD al mes. La horquilla es enorme, pero la decisión no se toma solo con esa cifra: depende de la tarea, de la caché, de los reintentos y de las horas de revisión.
La regla práctica es sencilla: usar el modelo más barato que complete la tarea con una verificación fiable, reservar el frontera para lo que no admite errores y medir el coste por tarea aceptada. Lo demás es optimizar la factura mientras se ignora el coste real.
Fuentes y precios consultados
Precios de lista consultados el 20 de octubre de 2026. No incluyen impuestos, descuentos por volumen ni batch. Verificar siempre en la página oficial antes de presupuestar.
Comentarios
Conversación
Los comentarios se apoyan en GitHub Discussions. Se cargan solo si pulsas el botón, para no enviar datos a GitHub al abrir el artículo.
Los comentarios estarán disponibles próximamente. Mientras tanto, puedes escribir a contacto@jmolo.es.